
- Анализ данных отраслевого отчета Hugging Face
- Специфика методологии подсчета активности
- Архитектурные особенности и спектр параметров
- Многоязычный словарь и плотность токенизации
- Сравнительный анализ открытых экосистем
- Влияние лицензионной политики на выбор бизнеса
- Практическое развертывание и методы сжатия весов
- Экономические последствия для облачной инфраструктуры
Анализ данных отраслевого отчета Hugging Face
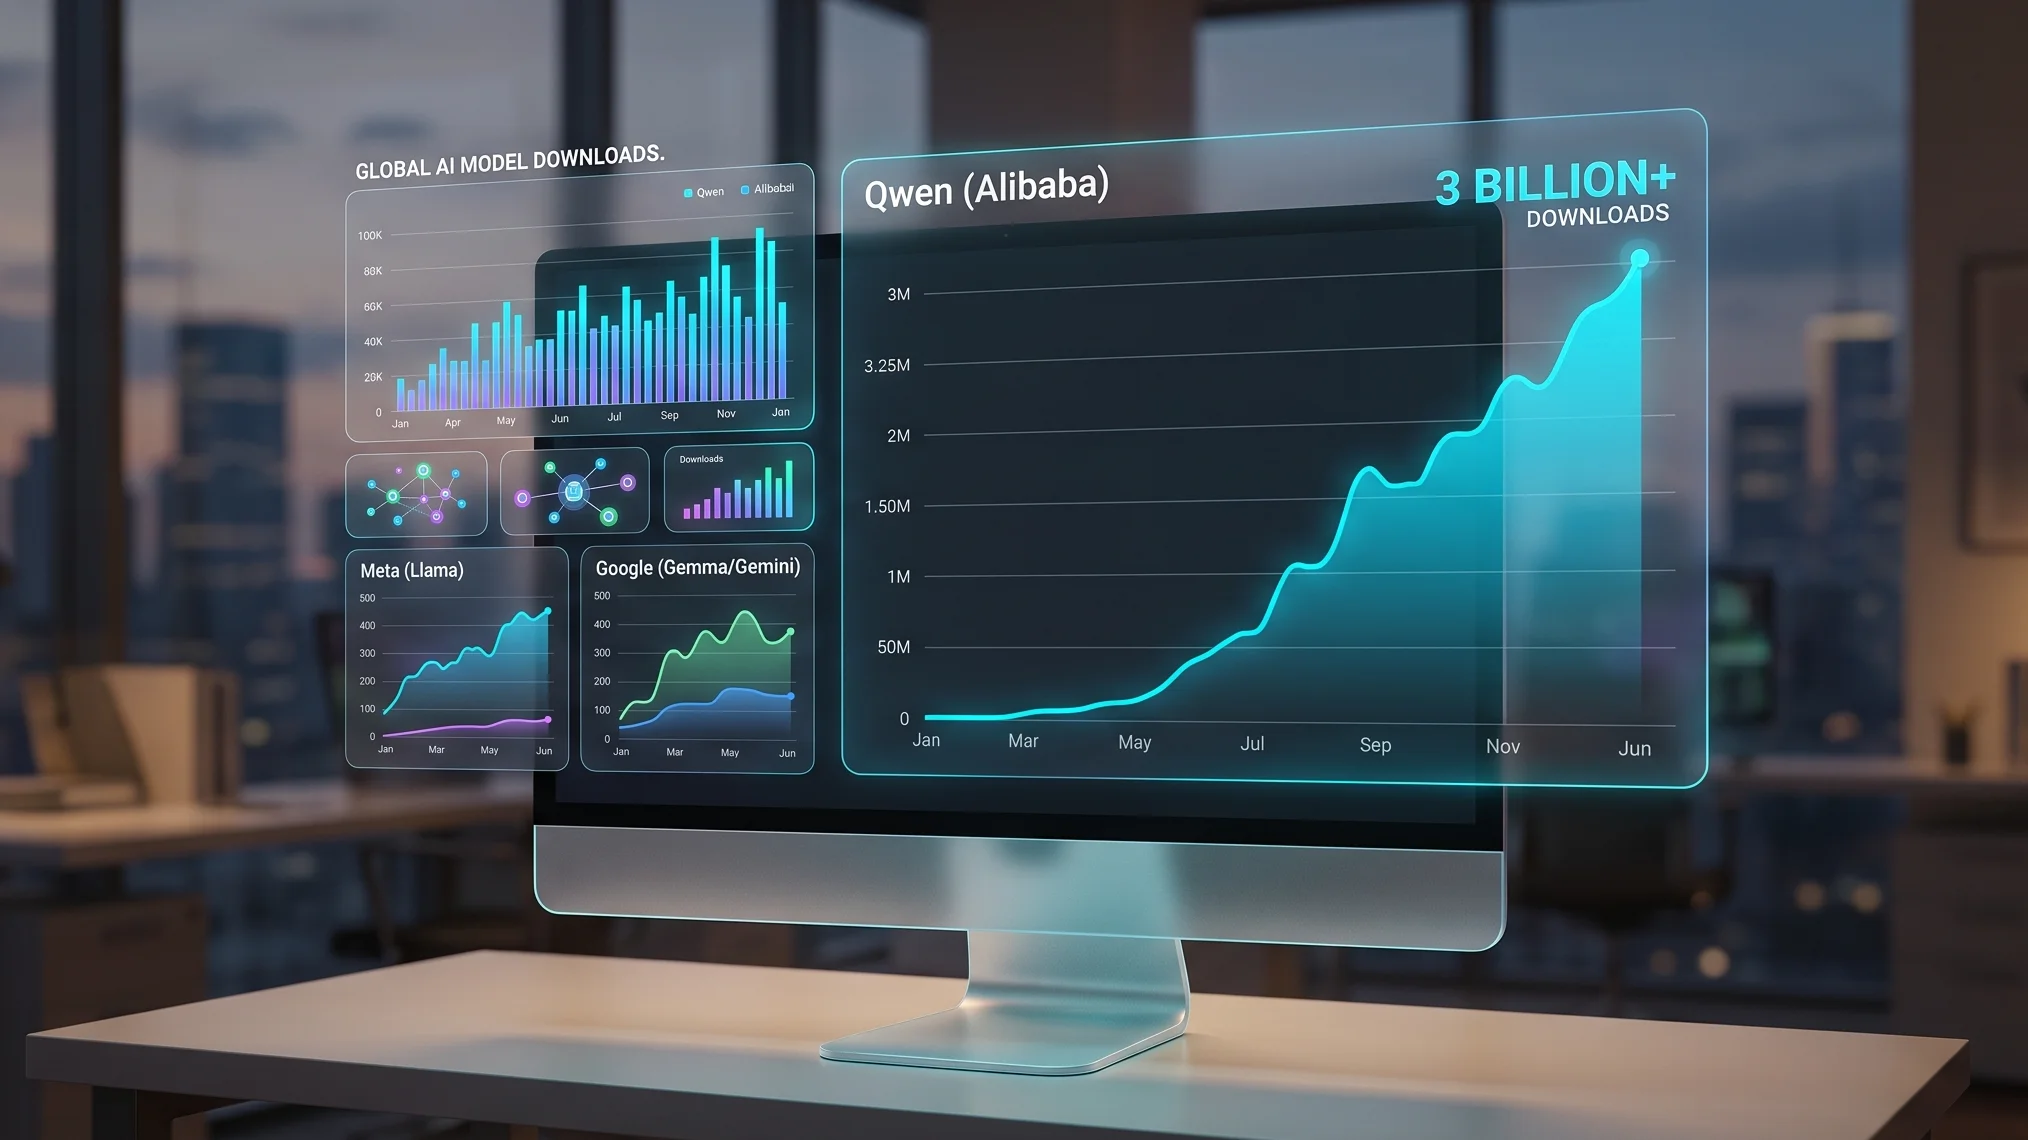
Китайская корпорация Alibaba зафиксировала существенный рост интереса международного сообщества разработчиков к собственному семейству открытых моделей искусственного интеллекта Qwen. Согласно официальным данным аналитического отчета платформы Hugging Face, которая отслеживает активность инженеров в области машинного обучения, суммарное количество загрузок моделей линейки Qwen преодолело исторический рубеж в 3 миллиарда раз. Этот показатель рассчитывался на основе внутренних логов платформы за последние шесть месяцев и наглядно демонстрирует изменение архитектурных приоритетов на мировом рынке генеративных систем. Для сравнения масштаба экосистем стоит отметить, что открытые решения от Google, в частности семейство Gemma, зафиксировали около 227 миллионов загрузок, тогда как модели серии Llama от корпорации Meta получили около 418 миллионов загрузок за аналогичный временной промежуток.
Стремительный рост популярности китайских разработок стал неожиданностью для многих западных аналитиков, которые традиционно прогнозировали безоговорочное доминирование американских технологических гигантов. Платформа Hugging Face фиксирует беспрецедентную динамику привлечения новых инженеров, которые массово тестируют, дообучают и внедряют инструменты Alibaba в собственные коммерческие продукты. Сложная структура рынка открытых технологий показывает, что доступность и гибкость настроек становятся решающими факторами при выборе фундаментальных моделей для корпоративного сектора.
Специфика методологии подсчета активности
Статистические показатели сервиса Hugging Face базируются на многоуровневой системе сбора метрик, которая учитывает не только прямые ручные загрузки файлов весов через графический интерфейс веб-браузера. Алгоритмы платформы осуществляют детальный мониторинг нескольких ключевых типов сетевого взаимодействия
- Автоматизированные запросы через API во время настройки серверной инфраструктуры, развертывания виртуальных машин и загрузки образов контейнеров Docker.
- Тестирование в пайплайнах непрерывной интеграции CI/CD где модели загружаются в автоматическом режиме для выполнения юнит-тестов и верификации совместимости кода.
- Прямое клонирование репозиториев с помощью систем контроля версий Git и специализированных клиентских библиотек Python.
- Трафик производных деривативов который возникает в процессе обращения разработчиков к сторонним модификациям, созданным на базе исходных весов.
Открытая философия распространения более 460 базовых моделей Qwen и более 300 000 их производных вариантов, разработанных глобальным сообществом путем тонкой настройки, запускает мощный эффект мультипликатора. Каждая модифицированная версия, загруженная на платформу независимыми исследователями, создает дополнительные потоки сетевого трафика во время тестирования и валидации другими специалистами.
Архитектурные особенности и спектр параметров
Инженерная стратегия подразделения Alibaba Cloud фундаментально отличается от подходов большинства западных лабораторий. Вместо выпуска ограниченного количества громоздких монолитных моделей, команда сосредоточилась на создании целостной линейки вычислительных инструментов под разные типы аппаратного обеспечения. Спектр моделей охватывает конфигурации от сверхкомпактных решений на 0.5 миллиарда параметров, рассчитанных на выполнение на мобильных чипах и встроенных системах, до полноразмерных кластерных вариантов на 110 миллиардов параметров, ориентированных на масштабируемые дата-центры.
Базовая архитектура опирается на оптимизированные блоки Transformer с интеграцией механизма группового запроса внимания (Grouped-Query Attention). Такое решение минимизирует объем кэша ключей и значений (KV-cache), что критически важно для сохранения пропускной способности подсистемы памяти графических процессоров при работе с расширенными контекстными окнами.
Многоязычный словарь и плотность токенизации
Отдельного внимания заслуживает структура собственного токенизатора Qwen. Расширенный словарный запас насчитывает более 151 000 уникальных токенов, что существенно превосходит показатели конкурирующих открытых решений. Благодаря оптимизированной сегментации входных последовательностей, токенизатор достигает значительно более высокой плотности сжатия текста на кириллических и восточноазиатских языках. Меньшее количество сгенерированных токенов для одного и того же фрагмента текста напрямую снижает нагрузку на вычислительные ядра и сокращает время задержки до первого токена (Time to First Token).
В промышленной эксплуатации облачных серверов, где средняя стоимость обработки вычислительных потоков варьируется от 0.20 USD до 0.90 USD за один миллион сгенерированных токенов, повышенная плотность упаковки информации обеспечивает существенную прямую экономию бюджета на инфраструктуру.
Сравнительный анализ открытых экосистем
Для понимания текущей структуры рынка открытых больших языковых моделей необходимо сопоставить ключевые технические и эксплуатационные параметры ведущих решений от Alibaba, Meta и Google. Приведенная таблица демонстрирует главные различия в конфигурациях и условиях использования.
Влияние лицензионной политики на выбор бизнеса
Юридический аспект использования моделей открытого кода часто имеет приоритетное значение для корпоративных клиентов. Большинство базовых весов семейства Qwen публикуется под классической пермиссивной лицензией Apache 2.0. Она предоставляет компаниям право свободно модифицировать код, развертывать его в закрытых контурах и включать в коммерческие проприетарные сервисы без дополнительных согласований или отчислений.
В противоположность этому, компания Meta использует специальное соглашение Llama Community License, которое требует получения персонального коммерческого разрешения в случае, если ежемесячная активная аудитория продукта превышает 700 миллионов пользователей. Хотя для большинства проектов эта граница недостижима, крупные корпорации стараются избегать потенциальных лицензионных рисков, отдавая предпочтение стандартам OSI.
Практическое развертывание и методы сжатия весов
Высокая скорость адаптации моделей Qwen обусловлена глубокой интеграцией с современным стеком инференса. Разработчики могут легко запускать модели на собственных серверах с помощью проверенных инструментов
- Высокопроизводительные движки vLLM и TGI которые обеспечивают эффективную упаковку запросов через механизм PagedAttention.
- Локальные сервисы Ollama и LM Studio для быстрого тестирования на рабочих станциях разработчиков без сложных настроек.
- Аппаратные библиотеки TensorRT-LLM для достижения максимальной скорости генерации на видеокартах производства Nvidia.
Особую роль в снижении стоимости эксплуатации играют передовые алгоритмы квантования, такие как AWQ (Activation-aware Weight Quantization) и GPTQ. Они уменьшают точность числовых значений весов из 16-битных типов (FP16 или BF16) до 4-битных целых чисел (INT4). Благодаря такой компрессии модель на 72 миллиарда параметров, которой в стандартном виде требуется более 140 ГБ видеопамяти, успешно размещается на двух коммерческих видеокартах с 24 ГБ VRAM каждая.
Специфика тонкой настройки
Процесс адаптации открытых моделей под узкие задачи бизнеса (fine-tuning) требует подготовки структурированных наборов данных. Применение методов параметрически-эффективного обучения, таких как LoRA и QLoRA, позволяет дообучать модели даже на скромном аппаратном обеспечении. Аренда облачных видеокарт для выполнения таких задач обычно обходится в диапазоне от 50 USD до 350 USD за один тренировочный цикл, что делает технологию доступной для небольших IT-команд.
Экономические последствия для облачной инфраструктуры
Успех семейства Qwen наглядно демонстрирует разрушение монополии закрытых проприетарных платформ. Многие технологические компании пересматривают собственную зависимость от коммерческих API, которые требуют значительных ежемесячных расходов при больших объемах трафика. Развертывание собственного экземпляра открытой модели на арендованном выделенном сервере (стоимостью примерно 250 — 450 USD в месяц) обеспечивает предсказуемость затрат, независимость от внешних сбоев и строгое соблюдение политик конфиденциальности при обработке персональных данных пользователей.
Дальнейшее развитие экосистемы вокруг разработок Alibaba ускоряет децентрализацию исследований в области искусственного интеллекта, формируя открытую конкурентную среду для разработчиков по всему миру.

0 Comments